背 JVM 时,我能说出堆、元空间、直接内存,也知道 OOM 之后应该拿 dump、看 GC 日志。但真把实验跑起来,问题就变具体了:MAT 为什么把一个 48 字节的 HashMap 列为最大嫌疑?线程池明明设了 64 个线程,怎么还没保留满 64 份上下文就 OOM?堆只用了几 MiB,为什么日志里也有 Full GC?
这次在 Windows 上,用 Microsoft OpenJDK 17.0.17、PowerShell 和 Eclipse MAT 1.16.1,做了一组 OOM 与 GC 实验。这里把代码、已有日志和 MAT 导出报告串起来,也把整理过程中发现的几处错误记下来。
文中的“日志显示”“报告显示”指现存产物;机制解释会结合代码与 JDK 实现;修复方案是后续应该验证的方向,不把它们写成已经完成的修复。容量计算使用二进制单位,1 MiB = 1024 × 1024 字节,日志里的 M 按这一口径阅读。
一、先把实验对象和证据摆出来
实验目录里有三份说明:README.md、MAT完全实操手册.md、FullGC排查实战手册.md。代码分成五组:
01-heap-leak         静态 Map 保存 Session,只放不删
02-threadlocal-leak  线程池上下文不清理,另有集合持续追加模式
03-metaspace-leak    反复创建类加载器,并持有加载器和 Class
04-direct-buffer-leak
                    allocateDirect 后一直保留 ByteBuffer
05-fullgc           短命对象、显式 GC、分配压力、大对象、元空间阈值
前四组用于制造不同类型的内存压力,第五组做对照。目录虽然叫 05-fullgc,里面的每个模式却不一定真的产生 Full GC。
本地统一通过脚本启动,例如:
.\lab.ps1 build
.\lab.ps1 heap
.\lab.ps1 threadlocal
.\lab.ps1 threadlocal unbounded
.\lab.ps1 metaspace
.\lab.ps1 direct
.\lab.ps1 fullgc humongous
脚本会打印实际 Java 命令,应该连同输出一起保存。它也会清理同名的旧日志、dump 和 MAT 索引;重跑前先按运行批次归档,才能保留可比较的证据。
现存证据包括 10 份 GC 日志、两份 HPROF,以及这两份 HPROF 对应的 MAT Leak Suspects 报告。堆转储分别来自静态缓存和 ThreadLocal bounded 实验。没有保存下来的其他 dump、实时 jstat 输出或调用栈,就不当作已经观察到的结果。
按完成的暂停事件重新统计,结果如下:
| 日志对应模式 | 收集器 | 最后记录的 uptime | Young 暂停 | Full 暂停 |
|---|---|---|---|---|
| 静态缓存 | G1 | 9.912 s | 52 | 34 |
| ThreadLocal bounded | G1 | 10.923 s | 26 | 4 |
| ThreadLocal unbounded | G1 | 1.432 s | 76 | 124 |
| 元空间泄漏 | G1 | 3.591 s | 11 | 5 |
| 直接内存 | G1 | 10.595 s | 0 | 1 |
| fullgc young | G1 | 7.147 s | 5 | 0 |
| fullgc systemgc | G1 | 16.172 s | 0 | 9 |
| fullgc promotion | G1 | 21.956 s | 292 | 19 |
| fullgc humongous | G1 | 18.005 s | 7600 | 0 |
| fullgc metaspace | Parallel | 17.969 s | 126 | 126 |
这里的 uptime 是当前日志能看到的最后时间,不是统一时长的基准测试;不同实验也不是用暂停次数直接比性能。Young 分类包含日志中以 Pause Young 表达的 Mixed 等暂停,不表示它们都只处理年轻代。并发周期、Remark、Cleanup 没有算进这两列。
尤其是 unbounded 模式,工作线程的 OOM 不会自动变成主线程退出,日志最后一行也不能证明整个进程在这一刻终止。它的现场只能说明:短时间内发生了大量回收尝试,末尾的存活占用仍然很高。
二、第一个发现:GC 次数被统计成了两倍
原来的计数方式是:
Select-String -Path $log -Pattern 'Pause Full'问题在于,-Xlog:gc* 会同时留下开始和结束记录:
[gc,start] GC(0) Pause Full (System.gc())
[gc     ] GC(0) Pause Full (System.gc()) 4M->1M(8M) 2.693ms
这是同一个 GC(0),不是两次回收。直接统计匹配行数,会把开始和结束都算进去。
因此,原文里的显式 GC 18 次,实际完成了 9 次;promotion 的 38 次 Full GC,实际是 19 次;Parallel 元空间模式的 252 次,实际是 126 次。
大对象日志更明显:匹配到 15201 行 Pause Young,其中 7600 条是带占用变化与耗时的完成记录,另有 7601 条开始记录。末尾那次只有开始行,没有对应完成行,不能强行算成一个已完成事件。
对本实验这种日志格式,可以这样统计:
$log = '.\gclogs\05-fullgc-humongous.log'
$completed = Select-String -Path $log -Pattern `
    'GC\(\d+\) Pause (Young|Full).*\d+M->\d+M\(\d+M\) [\d.]+ms$'

$young = @($completed | Where-Object { $_.Line -match 'Pause Young' })
$full  = @($completed | Where-Object { $_.Line -match 'Pause Full' })

"Completed Young pauses: $($young.Count)"
"Completed Full pauses:  $($full.Count)"
这段正则只针对当前以 M 为单位的样本。做通用分析时,还要兼容其他单位、日志轮转和多进程文件,按运行实例、GC ID 与事件类型去重。
我把本次重新统计的结果保留成了可下载的 JSON,包括原始匹配行数、完成事件数与原因分布。后面的数字都以这个统计口径为准。
三、静态缓存:最大的嫌疑为什么是一个小 Map
3.1 代码让哪些对象活了下来
HeapLeakDemo 用静态集合保存会话:
public static final Map<String, Session> SESSION_CACHE = new HashMap<>();

// 主循环持续执行,没有删除、过期或容量限制。
SESSION_CACHE.put(sid, new Session(sid, userId, payloadKb));
每个 Session 带一个 256 KiB 的 byte[] payload。同时,后台噪音线程持续创建 AccessLog,之后清空临时集合,模拟正常短命对象。
这组设计的价值是,dump 里并不只有“坏对象”。要分清临时分配和长期保留,不能看哪个类实例最多,就认定哪个类泄漏。
代码里真正的问题是生命周期不匹配:会话数据已经可以结束,静态缓存却一直持有。GC 只能判断对象是否仍可达,无法替业务判断某个过期会话是否有用。
3.2 先看暂停,再用 MAT 找持有者
日志末尾连续出现:
GC(97) Pause Full (G1 Compaction Pause) 193M->193M(256M) 1.597ms
GC(98) Pause Full (G1 Compaction Pause) 193M->193M(256M) 1.876ms
这说明当时的存活占用已经很难通过 Full GC 降下来。但这两行本身还不足以证明泄漏:业务确实需要的大存活集,也可能有同样表现。
MAT 报告提供了更直接的证据:
| 对象或类别 | 当前报告中的结果 |
|---|---|
| 最大 HashMap 的 Shallow Heap | 48 字节 |
| 同一 HashMap 的 Retained Heap | 201,277,216 字节,约 192 MiB |
| 占本次分析堆的比例 | 99.36% |
| Histogram 中的 Session 实例 | 768 个 |
| Map 保留集合中列出的 Session | 767 个 |
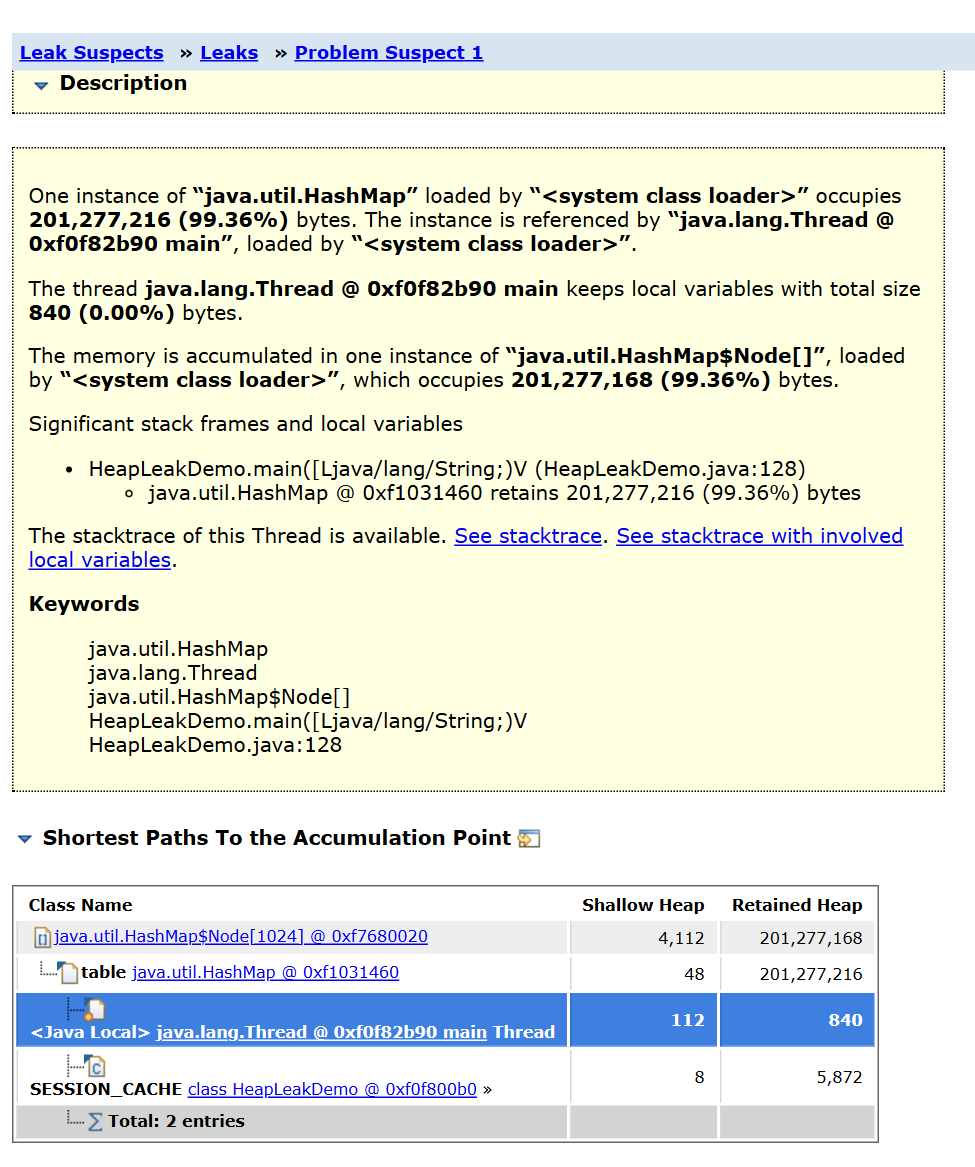
图 1:从现存 MAT 导出报告截取,数值对应本次保存的 dump。点击可放大。
Histogram 的实例数与 Map 保留集合的实例数不是同一个统计范围。当前线程还可能持有正在构造或尚未完整插入的对象,不能要求两者必然相等。
引用关系则能与源码对应起来:
HeapLeakDemo 的静态字段 SESSION_CACHE
  → HashMap
  → Node[] / Node
  → Session
  → payload: byte[]
“不断插入、没有淘汰”的代码,加上“Map 保留了几乎整个分析堆”的报告,才把泄漏原因落实到了具体位置。
3.3 Shallow Heap 与 Retained Heap 都要看
Shallow Heap 是对象自身占的空间;Retained Heap 描述在当前引用图中,由这个对象保留的那一组对象所占的堆空间。
所以小小的 Map 可以保留约 192 MiB。它本身不大,背后的节点、会话和数组才大。
也不能反过来说“永远只看 Retained Heap”。想知道内存主要花在哪类对象上,Histogram 的对象数与浅堆总量很有用;想定位哪个容器或线程控制了大量对象的生命周期,再看支配树和保留堆。两者回答不同的问题,定义见 MAT:Shallow vs. Retained Heap。
修复方向是给缓存容量、总字节量和生命周期建立边界。只限制条目数还不够:1 万条、每条 256 KiB,仅 payload 就约 2.44 GiB。是否使用本地缓存、集中式会话存储或按权重淘汰,要按业务选择,不能把一个固定配置当成通用答案。
这些方案尚未在当前实验里做修复后的对照验证。
四、ThreadLocal:有上限,也能在上限之前 OOM
4.1 这次不是 key 已经消失的故事
bounded 模式的关键代码是:
static final ThreadLocal<RequestContext> CONTEXT = new ThreadLocal<>();

pool.execute(() -> {
    CONTEXT.set(new RequestContext(uri, userId, 2048));
    // 缺少任务结束后的 remove。
});
线程池配置 64 个工作线程,每份上下文的 body 为 2 MiB。
ThreadLocalMap 的 Entry 的确使用弱引用保存 key,同时以普通强引用保存 value。本机 JDK 源码里能看到:
static class Entry extends WeakReference<ThreadLocal<?>> {
    Object value;
}
但这个实验的 CONTEXT 是 static final,一直被强引用。不能看到 ThreadLocal,就机械地解释为“key 被 GC 回收,留下 null key”。这里直接发生的是:长期存活的线程,通过 Entry.value 持有本应随请求结束的上下文。
存活的工作线程
  → threadLocals
  → ThreadLocalMap.table
  → Entry.value
  → RequestContext.body
弱 key 失效后 value 未及时清理,是另一种需要讨论的情形;清理依赖相应访问、扫描和线程退出等机制,不能保证下一次 GC 自动把 value 一并释放。可以对照 OpenJDK ThreadLocal 实现。
4.2 理论上 128 MiB,报告为什么只有约 82 MiB
64 × 2 MiB = 128 MiB,只是“每个线程保留一份固定大小 body”的 payload 上限估算,没包含对象头、属性 Map、线程池和收集器的布局成本。
现存 MAT 报告显示:
| 指标 | 结果 |
|---|---|
| 报告归组的 Thread 实例 | 58 |
| 这组线程保留的内存 | 86,149,600 字节,98.52% |
| RequestContext 实例 | 42 |
| ThreadLocalMap 实例 | 41 |
| 某个工作线程的浅堆 / 保留堆 | 112 / 2,101,096 字节 |
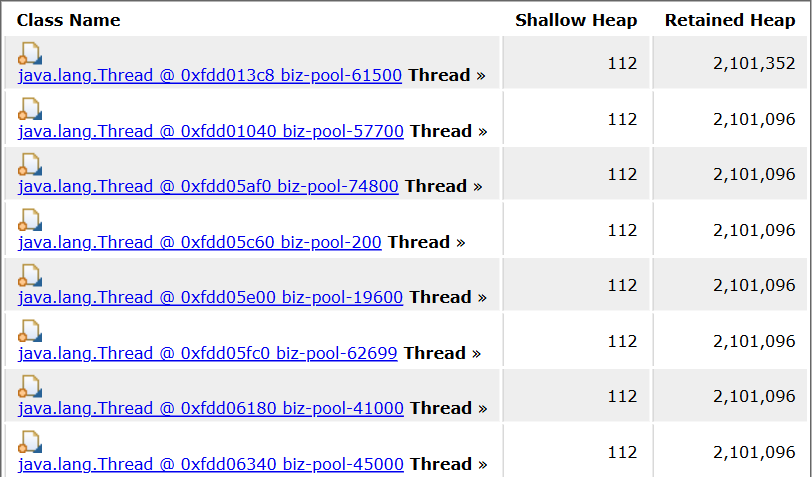
图 2:MAT 表格节选。报告列出的是一组线程,不能解释成 58 个线程都已成功保存同样大小的上下文。
这里还有 G1 大对象的影响。日志说明 Region 为 1 MiB,末尾出现:
GC(47) Humongous regions: 123->123
GC(47) Pause Full (G1 Compaction Pause) 124M->124M(128M) 1.733ms
一个 body 的元素数据已经正好 2 MiB,加上数组头等开销,总对象大小超过 2 MiB,需要占用三个连续的 1 MiB Region。最后一个 Region 的剩余部分不能再拿去装普通对象。
因此,约 41 份成功保留的 body,对应 41 × 3 = 123 个 Humongous Region,与日志吻合。MAT 中约 82 MiB 的数组数据,与 GC 日志中约 124 MiB 的占用并不矛盾,它们的统计对象不同。
这是结合源码、报告对象数和 Region 日志得出的解释,不是额外实测了每个对象的地址布局。它也说明,容量估算不能只做“线程数 × 数组长度”,更不能把理论最大线程数写成 OOM 现场已经成功持有的对象数。
4.3 bounded 与 unbounded 的区别
bounded 模式在同一个线程的同一个 key 上不断 set,新 value 替换旧 value,正常情况下不会把每一次历史上下文都累积在这个槽位里。它有一个与线程数、value 大小有关的保留上限,但这个上限完全可能超过可用容量。
unbounded 模式则不同:
static final ThreadLocal<List<byte[]>> BATCH_BUFFER =
        ThreadLocal.withInitial(ArrayList::new);

// 每次任务都往线程自己的 List 里追加。
BATCH_BUFFER.get().add(new byte[256 * 1024]);
value 自身一直增长,线程数固定也限制不了内存。并且这段实验使用固定线程池,任务队列本身没有配置业务上限;排查时还要分清,内存增长来自线程内集合、排队任务,还是两者共同作用。
常规请求上下文应在正确的生命周期边界清理:
try {
    CONTEXT.set(context);
    doBusiness();
} finally {
    CONTEXT.remove();
}
如果允许嵌套调用且外层已有上下文,还可能需要保存并恢复旧值;跨线程传递也不是加一个 finally 就自动解决。实验中没有实现这些修复,也没有做“清理后长期稳定”的对照。
五、MAT 怎么从“嫌疑对象”走到代码原因
两份报告值得按同一套步骤看一遍。
先用 Leak Suspects 缩小范围,再用 Histogram 判断对象类型与数量。之后看 Dominator Tree,确认谁控制了大块内存,最后沿 Path to GC Roots 找到长期持有关系。
支配树不是一棵普通字段展开树。对象 A 支配 B,指从 GC Roots 到 B 的所有路径都经过 A;树上相邻节点不保证源码中恰好有一个直接字段引用。这个区别见 MAT:Dominator Tree。
静态缓存报告还有一个细节:最短路径同时包含 main 线程的局部引用和 HeapLeakDemo.SESSION_CACHE。前者说明抓取快照时主线程正在使用这个 Map,后者才与长期保留策略直接相关。
不能把线程栈路径一律删掉。当前局部变量可能是短暂引用,也可能是一个长期挂起任务里真正保住对象的原因,需要结合调用栈和生命周期判断。
图 3:找引用链时,先区分谁持有对象,以及对象背后的数据在哪个区域。
查普通强引用保留时,可以先排除 weak、soft、phantom 的 referent 路径,减少干扰。但分析软引用缓存、Cleaner 或 ReferenceQueue 时,还要回到完整关系;过滤选项并不能代替理解引用机制。
有两个实用查询:
SELECT * FROM HeapLeakDemo$Session

SELECT * FROM byte[] b WHERE b.@length > 1048576
第二条按数组元素长度筛选大 byte[],并不是直接按 G1 Region 占用筛选。MAT 的 OQL 也不是通用 SQL,不能默认支持手册里随手写出的 COUNT(*)、GROUP BY 等写法,语法要按 MAT OQL 文档 核对。
当前静态缓存报告的线程栈还保留了 HeapLeakDemo$Session.<init> 与 HeapLeakDemo.main,能定位当时失败的分配位置。不过,是否包含有用栈帧取决于 dump 的内容和生成时机,不能保证所有自动 dump 都完整保存,也不能说手动 dump 一定没有线程栈。
六、元空间:堆很空,类元数据也可以先耗尽
MetaspaceLeakDemo 反复读取同一份 Template 字节码,用不同 ClassLoader 定义同名类:
HotDeployClassLoader loader = new HotDeployClassLoader();
Class<?> type = loader.loadClass("Template");

LEAKED_LOADERS.add(loader);
LEAKED_CLASSES.add(type);
类名一样,不代表 JVM 里只有一份类型。定义类加载器不同,就可以得到不同的类身份,也需要不同的元数据。
代码同时保存加载器与 Class,阻止这组旧加载器失去可达性。对由这些普通自定义加载器定义的类,加载器仍存活,就无法按预期卸载整批类。它模拟的是热部署等场景中的生命周期泄漏,不是只要使用动态类加载就必然泄漏。
启动参数给元空间设了 128 MiB 上限。日志末尾能看到:
GC(19) Metaspace: 99840K(131072K)->99834K(131072K)
GC(19) Pause Full (Metadata GC Threshold) 13M->13M(47M) 9.963ms
堆只占约 13 MiB,不是这次主要压力来源。Metaspace 的 used 和 committed 也不是一个数字:99840K 是已用,括号内 131072K 是已提交的容量。空闲块、分配粒度等因素会影响继续分配,不能要求 used 精确等于配置上限,错误才会发生。
“G1 下元空间阈值不会产生 Full GC”不成立
手册曾把一次可卸载场景的观察概括成“G1 不会产生这种 Full GC”。但现存 03-metaspace-leak.log 的第一行就是 Using G1,后面完成了三次原因是 Metadata GC Threshold 的 Full 暂停,以及两次 Metadata GC Clear Soft References Full 暂停。
所以这份日志本身已经给出了反例。G1 可以先通过并发相关路径尝试处理元空间压力,处理不了时仍可能进入 Full GC。这里既要区分收集器,也要区分加载器可卸载与被长期持有的两种负载。
第五组的 metaspace 模式故意不保存 loader,并使用 Parallel GC。它在当前记录中完成了 126 次 Young、126 次 Full 暂停,原因均为元空间阈值。这与“持续制造类、又允许卸载”的设计相符,但当前没有保存独立的类卸载日志或 jstat 采样,不能把具体卸载数量也补写成实测结果。
排查时我会组合观察:
jstat -gc <PID> 1000
jstat -class <PID> 1000
jcmd <PID> VM.metaspace
jcmd <PID> VM.classloader_stats
MetaspaceSize 影响初始触发 GC 的高水位,后续会调整,不是“启动就预分配这么多元空间”;MaxMetaspaceSize 才是相关容量上限。阈值设置能影响 GC 频率,但修复不了被静态集合强引用的加载器。
七、直接内存:谁在调用 System.gc()
DirectBufferLeakDemo 的堆上限是 64 MiB,直接内存上限是 256 MiB,每次申请 8 MiB:
static final List<ByteBuffer> LEAK = new ArrayList<>();

LEAK.add(ByteBuffer.allocateDirect(8 * 1024 * 1024));
手册记录了申请第 33 块时的异常:已分配 268435456 字节,达到 256 MiB 限额,再申请 8388608 字节失败。现存 GC 日志则留下了另一条证据:
GC(0) Pause Full (System.gc()) 4M->1M(8M) 2.693ms括号中的 8M 是当时的堆容量,不是配置的最大堆;此次 GC 还发生了缩堆。不能把它读成“这次应用只配置了 8 MiB 堆”。
业务代码没有显式调用 System.gc,为什么原因里会出现它?本机 JDK 的 java.nio.Bits.reserveMemory() 提供了答案:直接内存额度不足时,它会等待引用处理、重试,必要时调用 System.gc(),之后再带退避地尝试申请,最终仍失败才抛 OOM。
它希望无人引用的 DirectByteBuffer 能被处理,进而释放背后的本地内存。但当前实验把每个 buffer 都放进静态 List,GC 无法因此释放仍被持有的 buffer。堆从 4M 降到 1M,也救不回这批直接内存。实现可参照 OpenJDK Bits.java。
7.1 DirectByteBuffer 对象和数据不在同一个地方
DirectByteBuffer 的包装对象在 Java 堆上,实际数据在本地内存。MAT 的 Shallow/Retained Heap 不会把那一整块本地缓冲区自动加进去。
但“MAT 对堆外 OOM 完全没用”也太绝对。只要拿到合适的 heap dump,就能检查 wrapper 被谁持有、capacity 大小和引用链;ClassLoader 泄漏也能借助堆里的 loader、Class 和持有者定位。只是堆快照不能完整计量 native 数据。
| 要回答的问题 | 更合适的观察方式 |
|---|---|
| 谁持有 DirectByteBuffer 或 ClassLoader | heap dump、MAT 引用链 |
| NIO direct buffer 数量与容量趋势 | BufferPoolMXBean 的 Count、TotalCapacity、MemoryUsed |
| JVM 追踪到的本地内存分类变化 | 提前启用 NMT,再看 summary 与差值 |
| 整个进程的驻留内存 | 操作系统、容器指标 |
NMT 不完整覆盖所有第三方 native 分配,也不能把它的 committed 简单当作 RSS。MaxDirectMemorySize 也不是所有堆外内存的总预算。这些工具各有统计范围,需要交叉对照,相关边界见 JDK 诊断工具文档。
7.2 开了自动 dump,也不保证所有 OOM 都有文件
为了核对手册里的这句话,整理时用相同的实验类补做了一次独立验证:堆 32 MiB、直接内存上限 16 MiB、每块 8 MiB,显式开启 HeapDumpOnOutOfMemoryError 并设置一个新的输出位置。
结果是第三次申请失败:
java.lang.OutOfMemoryError:
Cannot reserve 8388608 bytes of direct buffer memory
(allocated: 16777216, limit: 16777216)
    at java.nio.Bits.reserveMemory(Bits.java:178)
退出码为 1,没有生成对应的 hprof。这次验证没有覆盖原来的实验产物。
这里的 OOM 是 Java 层 Bits 主动构造并抛出的异常,不能假定它一定经过 VM 为分配失败安排的自动 heap dump 路径。同理,进程被操作系统或容器终止,也不能指望 JVM 总有机会留下 dump。
需要分析直接内存持有者时,可以提前采集监控,并在合适时机主动抓堆。但 jcmd GC.heap_dump 属于高影响操作,默认还会请求 Full GC;它不是无扰动观察,具体选项以目标 JDK 的 help 为准,见 jcmd 文档。
7.3 JDK ByteBuffer 与 Netty ByteBuf 不要混写
这个实验使用的是 JDK ByteBuffer,没有 Netty 的引用计数 release API。Netty 的 ByteBuf 则要按它自己的所有权、引用计数规则管理。
手册中把 ReferenceCountUtil.release(buf) 放在 JDK ByteBuffer 示例下面,并不能因此释放普通 ByteBuffer 的 native 内存。也不能仅凭日志出现 System.gc(),就认定是某个 Netty 释放方法造成的。
同样,DisableExplicitGC 不会自动制造一个强引用泄漏,但它可能影响直接内存不足时的回收兜底路径。ExplicitGCInvokesConcurrent 让相应显式请求走并发相关路径,也不代表整个周期零 STW。参数取舍要用实际负载验证,当前静态 List 不释放的根因不会因换一个参数而消失。
八、Full GC 对照组:同一个名字,可能是不同压力
8.1 短命对象与显式 GC
young 模式每轮生成一批 8 KiB 数组,随后清空临时 List。现存约 7.1 秒的记录中,完成了 5 次 Young 暂停,没有 Full 暂停。这是在当前负载和观察窗口内的结果,不意味着短命对象永远不会晋升。
systemgc 模式在循环中每两秒调用一次 System.gc()。当前记录完成了 9 次 Full 暂停,原因全部是 System.gc(),即使堆占用只有几 MiB,也照样发生。
前者说明分配频繁未必需要 Full GC;后者说明 Full GC 也未必由堆已满触发。GC 的类型、原因、占用变化和耗时,要放在一起看。
8.2 promotion 模式不只是“普通对象晋升”
这组代码每轮创建 600 个 64 KiB 短命数组,并向有上限的 LinkedList 加入一个 4 MiB 数组,最多保留 28 个。
日志里出现了 To-space exhausted,并完成了 19 次 Full 暂停。其中一条是:
GC(409) Pause Full (G1 Compaction Pause) 248M->178M(256M) 2.651ms它确实能回收掉相当一部分内存。但这不能推广成“只要能回收就一定没有泄漏”:一个应用可以同时有正常垃圾和另一批正在泄漏的对象。
更需要注意的是,这组 G1 Region 为 1 MiB,4 MiB 数组本身也走 Humongous 分配。它不是一个隔离得很干净的“普通小对象从 Eden 晋升”的实验。当前证据更适合把它称为:持续分配、较大存活集与大对象共同造成的回收压力。
图 4:每个点来自一条已完成暂停的 summary;折线只连接观测点,不代表连续监控曲线。橙色点标出 Full 暂停后的占用。
图中静态缓存末尾接近平台,而有上限集合仍会周期性释放一部分空间。判断具体哪组存在生命周期错误,还要回到代码与引用链,而不是只凭曲线形状。
8.3 Humongous 模式:Full 为零,暂停仍然很多
这组参数是:
-Xmx256m -XX:+UseG1GC -XX:G1HeapRegionSize=2m
FullGcDemo humongous 6 24 0
每个数组 payload 为 6 MiB,最多保留 24 份,循环没有主动休眠。对象总大小还包括数组头,完整占用可能跨到第 4 个 2 MiB Region,不能只按 6 × 24 = 144 MiB 估算收集器需要的空间。
当前约 18 秒日志完成了 7600 次 Young 暂停,Full 为零。完成的 Young 暂停耗时相加约 2715 ms,粗略相当于这段日志跨度的 15%。这个加和不包含所有 GC 相关阶段,也没有测到业务吞吐或 P99,不能把它直接写成线上延迟结论。
而且,日志中明确有:
GC(0) Pause Young (Concurrent Start) (G1 Humongous Allocation)
      115M->112M(256M) 1.170ms
因此,原文“完全没有出现 G1 Humongous Allocation”要修正。这个原因字符串反复出现了,只是事件类型是 Young,而不是期待中的 Full。
G1 的大对象会直接占用老年代中连续的 Region,也会影响标记启动和分配压力。某些不可达的基本类型大数组能在 Young 暂停中被提前回收,并不是非要 Full GC 才能释放。具体机制可对照 JDK 17 G1 文档。
这次给我的提醒是:不能把 GC 原因字符串与事件类型绑定,也不能把“FGC=0”当成“GC 开销很低”。
九、把几条过于绝对的结论改掉
整理实验记录时,下面这些说法需要收窄:
| 原来的表述 | 更准确的说法 |
|---|---|
| Full GC 后降不下来就是泄漏 | 表示存活集较大;结合增长趋势、引用链与业务生命周期判断 |
| 回收后降了很多就没有泄漏 | 正常垃圾与泄漏可能并存 |
| ThreadLocal 泄漏都有线程数乘 value 大小的上限 | 固定 key、固定线程数、固定 value 大小才适合这个估算;value 本身可无限增长 |
| G1 不会因元空间压力 Full GC | 当前元空间泄漏日志就有明确反例 |
| 没出现 Humongous Allocation | 当前日志中大量出现,只是属于 Young 暂停 |
| MAT 只能用于 heap space,堆外问题完全无用 | 看不到完整 native 数据,但可检查堆内持有者和引用关系 |
| 自动 dump 开关保证每种 OOM 都留下文件 | 要看异常来源、生成路径与现场条件 |
| GC 日志括号里的容量就是 Xmx | 它是该行描述的当时堆容量,可能与最大值不同 |
| 调大元空间阈值或新生代就能解决 | 先确认压力类型、容量与生命周期错误,再验证参数效果 |
尤其不应该把“解决方案”直接写成固定参数模板。对 G1,固定 -Xmn 等新生代大小会限制其自适应暂停控制,官方调优指南也建议避免先这样做,见 G1 Tuning。
这份笔记里的修复建议,还需要分别验证:缓存设限后是否稳定,ThreadLocal 清理后是否停止保留,释放加载器后能否卸载类,直接内存 buffer 不再持有后能否回落。当前实验没有保存这些修复后的对照产物。
十、下一次排查,我会按什么顺序走
先确认现象:Java 抛出的具体 OOM 是什么,还是进程被系统杀掉?堆、元空间、direct buffer 和 native thread 的入口不同。
再核对同一次运行的 JDK、收集器、参数、日志与 dump。不要把前一次手册里的数字,与后来重跑覆盖的日志拼成一个现场。
然后看趋势和原因。读取 GC 完成行、暂停分布、回收前后变化,同时按需要补充:
# 实时 GC 与原因
jstat -gcutil <PID> 1000
jstat -gccause <PID> 1000

# 堆与类加载器
jcmd <PID> GC.heap_info
jstat -class <PID> 1000
jcmd <PID> VM.metaspace
jcmd <PID> VM.classloader_stats

# 需要在启动时启用 NativeMemoryTracking
jcmd <PID> VM.native_memory baseline
# 经过一段具有代表性的负载之后
jcmd <PID> VM.native_memory summary.diff
jstat -gccause 是采样,不能替代完整事件历史。实例很快退出时,提前打开的日志通常更有用;原有 gc* 默认 info 级别也不等于已经打开详细对象年龄表,需要时应明确配置 gc+age=trace。
需要对象证据时,再选择合适时机抓 dump,用 MAT 完成“类型、保留量、引用路径、业务生命周期”的对应。怀疑持续泄漏,可以在可比负载下对比多份快照,但持续增长也可能是正常缓存预热,仍不能省略业务判断。
最后再验证修复。目标不是让错误晚一点出现,也不是只让 FGC 列停止增长,而是让资源随业务结束释放,让容量和负载存在可解释的边界。
这组实验让我记住的,是几个具体现场:一个 48 字节的 Map 保留约 192 MiB;2 MiB 的数组数据在 1 MiB Region 下可能消耗三个 Region;直接内存分配失败也会留下 System.gc() 原因;7600 次 Young 暂停可以和零次 Full 暂停同时出现。下一次再看 JVM 指标时,我会先问这些数字统计的是什么,再判断它说明了什么。
FIELD NOTES / DISCUSS
文章讨论
读完后,欢迎留下你的补充、疑问或不同看法。
正在读取评论…